问答
火山方舟CodingPlan支持哪些模型 CodingPlan模型的额度消耗速度对比
- 2026-09-24
- 嗯
- 本站原创
火山方舟 Coding Plan 是火山引擎推出的 AI 编程订阅套餐,它最值钱的一点是:一份套餐横跨五家厂商的模型——字节豆包、智谱 GLM、DeepSeek、Kimi、MiniMax 都在里面。想换模型,不用再单独去别家开户充值。火山引擎工具地址:https://ai8.net/navigation/AIxunlianmoxing/AIbangonggongju/2025/1223/1512.html
这篇把三件事讲清:现在到底支持哪些模型、哪几个模型"吃额度"要避开、不同场景该怎么选。
先提醒一句:模型清单一直在变,官方的说法是"动态加入更多出色的编程模型"。本文清单为截至 2026 年 9 月的官方口径,实际以控制台展示为准。
一、先看清单:一个套餐里有哪些模型
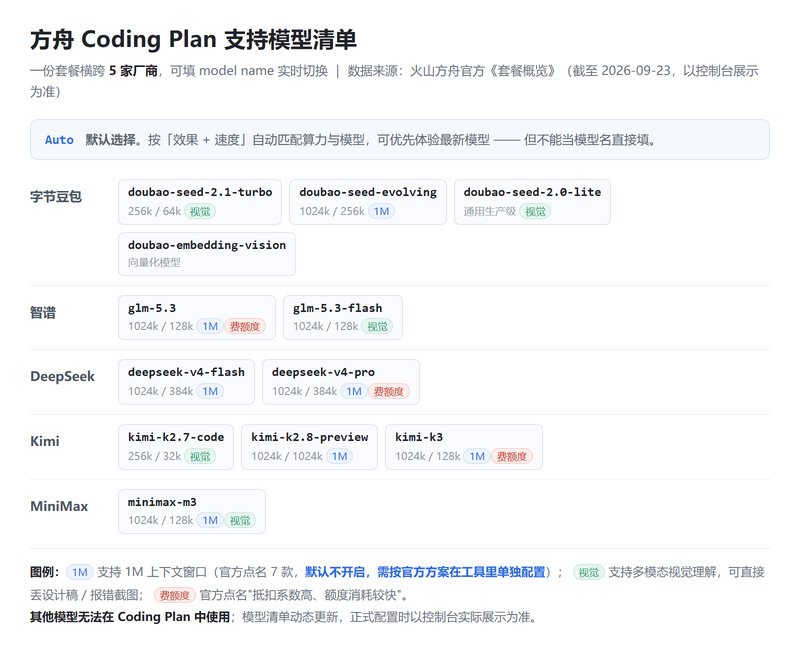
填这些模型名的时候注意:保持全小写英文原文。
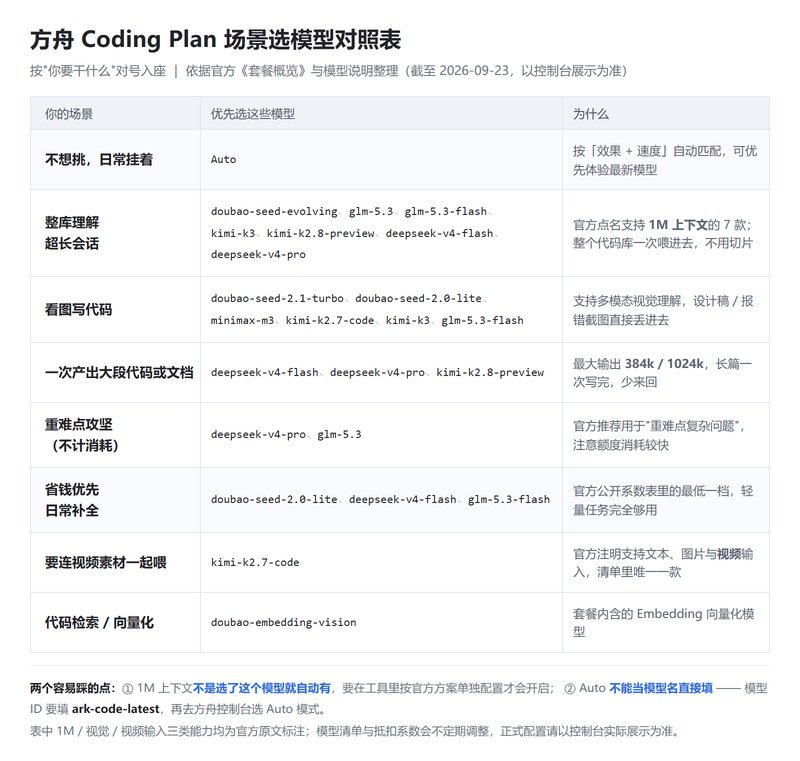
二、按场景选模型一张对照表看清楚
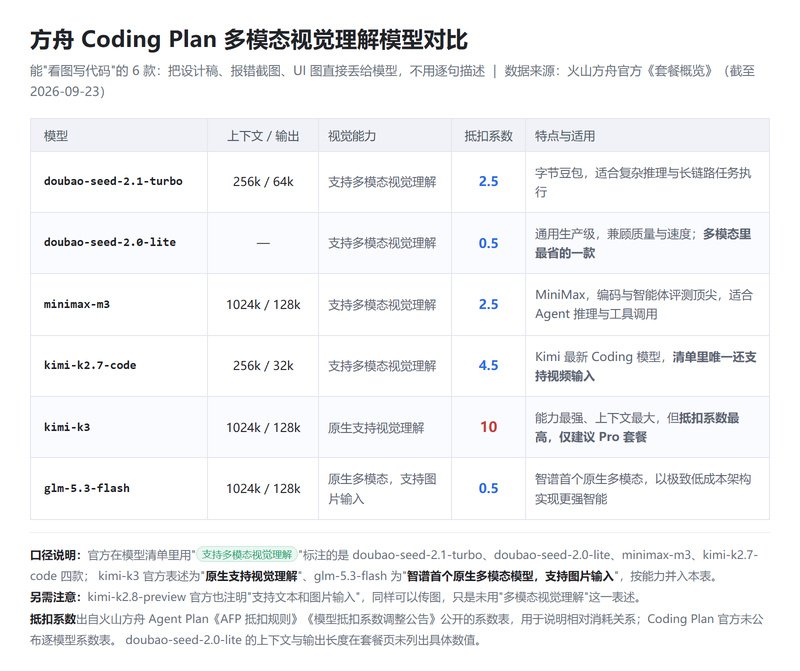
官方标注支持多模态视觉理解的模型有 6 款:doubao-seed-2.1-turbo、doubao-seed-2.0-lite、minimax-m3、kimi-k2.7-code、kimi-k3、glm-5.3-flash
这些模型如何按场景选择使用,各有什么优势,可以直接看图:
1M 上下文就是就是把整个大型代码库一次性喂进去,不用切片、不用反复跟它解释背景。官方说明这是给"包含大型代码库的长会话"用的。
官方表示支持 1M 上下文的是这 7 款:doubao-seed-evolving、glm-5.3、glm-5.3-flash、kimi-k3、kimi-k2.8-preview、deepseek-v4-flash、deepseek-v4-pro。
但要注意:1M 上下文默认不一定开着,需要在工具里按官方方案单独配置才能开启,不是选了这个模型就自动有。
五、三个"吃额度"的模型,最容易踩坑
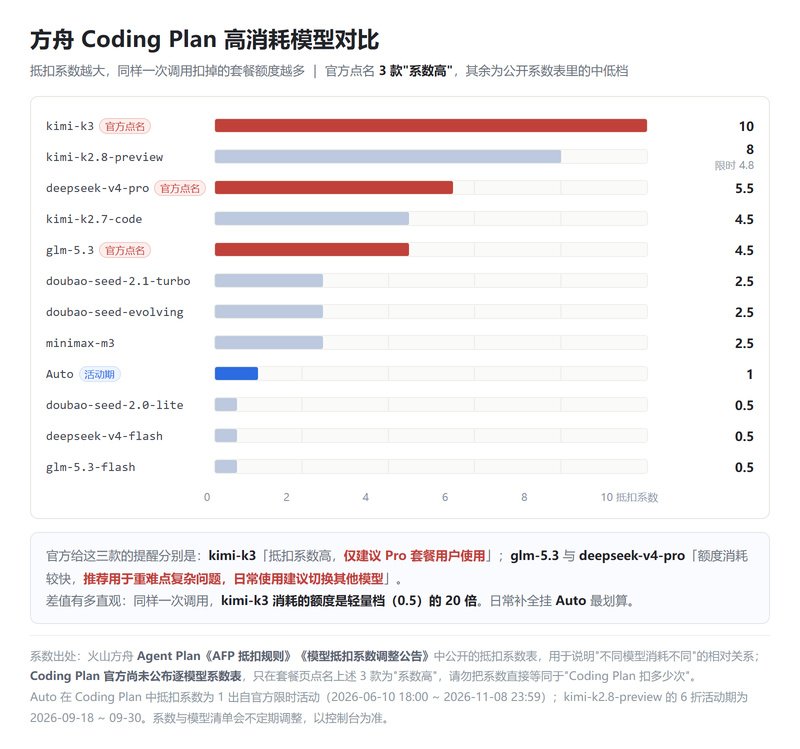
官方在模型清单里,单独给三个模型加了提醒(图中标红)同样一次调用,用不同模型,扣掉的额度不一样。
kimi-k3被官方明确写了"仅建议 Pro 套餐用户使用"。如果你买的是 Lite,建议避开它。
Auto 是官方列表之外的默认选项,按"效果 + 速度"两个维度自动匹配模型。用之前先记住两个关键点:
1.Auto 不能当模型名直接填。 想用 Auto,得把模型 ID 填成 ark-code-latest,然后去方舟控制台选 Auto 模式。很多人卡在这一步,因为在工具里根本找不到"Auto"这个词。
2.Auto 是省额度的选择。 官方限时活动里,Auto 在 Coding Plan 中的抵扣系数是 1(活动期到 2026-11-08),而 kimi-k3 的系数是 10。抵扣系数可以理解成"扣额度倍数",系数越高,同样一次调用扣得越多。
官方补充使用小妙招:Auto 会路由到 kimi-k3,而且夜间 00:00–08:00 路由到 kimi-k3 的比例会大幅提升。想白用一次 K3,就选择半夜使用。
相信通过阅读本文,你会对方舟 Coding Plan 支持哪些模型心里有数。本文主要介绍了 Coding Plan 的完整模型清单、需要避开的"高消耗"模型,以及不同场景该怎么选。最后再提醒一句:模型清单和抵扣系数官方会不定期调整,正式配置时请以控制台实际展示为准。希望这篇文章能对此有所帮助。
这篇把三件事讲清:现在到底支持哪些模型、哪几个模型"吃额度"要避开、不同场景该怎么选。
先提醒一句:模型清单一直在变,官方的说法是"动态加入更多出色的编程模型"。本文清单为截至 2026 年 9 月的官方口径,实际以控制台展示为准。
一、先看清单:一个套餐里有哪些模型
方舟CodingPlan支持模型清单
可直接复制的版本:doubao-seed-2.1-turbo、doubao-seed-evolving、doubao-seed-2.0-lite、glm-5.3 glm-5.3-flas、deepseek-v4-pro、kimi-k2.7-code、kimi-k2.8-preview kimi-k3、minimax-m3、doubao-embedding-vision填这些模型名的时候注意:保持全小写英文原文。
二、按场景选模型一张对照表看清楚
方舟CodingPlan按场景选模型对照表
三、要能看图,就选这几款官方标注支持多模态视觉理解的模型有 6 款:doubao-seed-2.1-turbo、doubao-seed-2.0-lite、minimax-m3、kimi-k2.7-code、kimi-k3、glm-5.3-flash
这些模型如何按场景选择使用,各有什么优势,可以直接看图:
多模态视觉理解模型对比图
四、想整库理解代码,认准 1M(百万token) 上下文这几款1M 上下文就是就是把整个大型代码库一次性喂进去,不用切片、不用反复跟它解释背景。官方说明这是给"包含大型代码库的长会话"用的。
官方表示支持 1M 上下文的是这 7 款:doubao-seed-evolving、glm-5.3、glm-5.3-flash、kimi-k3、kimi-k2.8-preview、deepseek-v4-flash、deepseek-v4-pro。
但要注意:1M 上下文默认不一定开着,需要在工具里按官方方案单独配置才能开启,不是选了这个模型就自动有。
五、三个"吃额度"的模型,最容易踩坑
官方在模型清单里,单独给三个模型加了提醒(图中标红)同样一次调用,用不同模型,扣掉的额度不一样。
kimi-k3被官方明确写了"仅建议 Pro 套餐用户使用"。如果你买的是 Lite,建议避开它。
CodingPlan高消耗模型对比
六、不想选就选 Auto,顺手还能省额度Auto 是官方列表之外的默认选项,按"效果 + 速度"两个维度自动匹配模型。用之前先记住两个关键点:
1.Auto 不能当模型名直接填。 想用 Auto,得把模型 ID 填成 ark-code-latest,然后去方舟控制台选 Auto 模式。很多人卡在这一步,因为在工具里根本找不到"Auto"这个词。
2.Auto 是省额度的选择。 官方限时活动里,Auto 在 Coding Plan 中的抵扣系数是 1(活动期到 2026-11-08),而 kimi-k3 的系数是 10。抵扣系数可以理解成"扣额度倍数",系数越高,同样一次调用扣得越多。
官方补充使用小妙招:Auto 会路由到 kimi-k3,而且夜间 00:00–08:00 路由到 kimi-k3 的比例会大幅提升。想白用一次 K3,就选择半夜使用。
相信通过阅读本文,你会对方舟 Coding Plan 支持哪些模型心里有数。本文主要介绍了 Coding Plan 的完整模型清单、需要避开的"高消耗"模型,以及不同场景该怎么选。最后再提醒一句:模型清单和抵扣系数官方会不定期调整,正式配置时请以控制台实际展示为准。希望这篇文章能对此有所帮助。
相关文章
- 火山引擎Seedream5.0介绍 Seedream5.0pro和flash功能与价格
- 火山方舟Coding Plan卡不卡方舟 Coding Plan卡顿限流怎么解决
- Coding Plan次数怎么算方舟 Coding Plan额度计算与刷新规则
- Coding Plan Lite是什么方舟 Coding Plan Lite套餐够用吗怎么买
- Coding Plan如何接入Trae 方舟、千问、Kimi、Minimax、智谱Coding Plan订阅接入教程
- 火山方舟Coding Plan性价比怎么样方舟Coding Plan值不值得买
- Seedance 2.5能生成多长视频Seedance 2.5视频时长上限
- 火山引擎seedance2.5每天免费算力是多少?哪些软件可以免费用seedance2.5生成视频